Сайт не индексируется: причины и порядок проверки, диагностика для Яндекса и Google
Содержание
- Коротко: порядок проверки в 7 шагов
- Шаг 0. Убедиться, что проблема вообще есть
- Шаг 1. Что говорят панели вебмастера
- Шаг 2. Запреты на стороне сайта
- Шаг 3. Доступность для робота: коды ответа, защита, хостинг
- Шаг 4. Знает ли поисковик о странице
- Шаг 5. Отрендерился ли контент
- Шаг 6. Робот был, но страницу отверг
- Шаг 7. Краулинговый бюджет на больших сайтах
- Анализ логов сервера: за 20 минут понять, приходил ли робот
- Таблица: симптом, вероятная причина, чем проверить, что сделать
- Особые случаи: Битрикс, мультиязычность, YMYL, переезды
- Проиндексировано, но трафика нет: почему это другая задача
- Индексация как бизнес-метрика: что чинить первым
- Чего делать не надо
- Проверка индексируемости для AI-ответов и нейропоиска
- Что можно сделать самому за час, а где нужен разработчик
- Частые вопросы
- Если разбираться самому некогда
Списки «7 причин, почему сайт не индексируется» почти не помогают: причины не независимы, и без порядка проверки вы перебираете гипотезы вслепую. Нужен маршрут, где каждый шаг отсекает часть вариантов.
Больше половины обращений «сайт не индексируется» заканчиваются тем, что всё в порядке, просто прошло пять дней. Ниже тот же чеклист, по которому мы в КлиентЛабе разбираем клиентские проекты с 2012 года: сначала Яндекс (в России он даёт заявки), потом Google.
Главная мысль, которой нет в топе: индексация не техническая галочка, а бизнес-метрика. Важно не «сколько URL в индексе», а какие коммерческие страницы выпали и сколько это заявок. Статья рассчитана и на владельца сайта («проверь за 10 минут»), и на разработчика («отдай логи»).
Коротко: порядок проверки в 7 шагов
- Шаг 0. Убедиться, что проблема есть: оператор site:, URL Inspection в GSC, «Проверить статус URL» в Яндекс.Вебмастере. Сайту три дня, это не проблема.
- Шаг 1. Прочитать панели: «Индексирование страниц» в GSC, «Страницы в поиске» и «Диагностика» в Вебмастере. Статус задаёт маршрут.
- Шаг 2. Снять запреты: robots.txt, meta robots, X-Robots-Tag, canonical, галочка noindex в CMS.
- Шаг 3. Проверить доступность: коды ответа, редиректы, 403/429/503, WAF и Cloudflare, блокировка YandexBot, гео-ограничения хостинга.
- Шаг 4. Убедиться, что поисковик знает о странице: sitemap.xml, lastmod, перелинковка, сироты, переобход, IndexNow.
- Шаг 5. Проверить рендер: JS, lazy-load, контент под кликом.
- Шаг 6. Если робот был и отверг: дубли, «Мало полезный контент», тонкие страницы, автогенерация.
- Шаг 7. На больших сайтах: краулинговый бюджет, фасеты, пагинация, UTM, Last-Modified и 304.
Правило маршрута: не прыгать между шагами. Около 80% случаев закрываются на шагах 0-3, и именно их пропускают чаще всего.
Шаг 0. Убедиться, что проблема вообще есть
Проблема есть, если авторитетные источники (панели вебмастеров) подтверждают отсутствие страницы в индексе, а срок уже вышел. Оператор site: для этого не годится: он даёт приблизительное число и разные результаты при повторных запросах.
Три способа проверки
Яндекс.Вебмастер, «Индексирование», «Проверка страницы»: единственный точный ответ по конкретному адресу в Яндексе. Google Search Console, «Проверка URL»: смотреть не только вердикт, но и поля «Последнее сканирование», «Канонический URL, выбранный Google», «Обнаружение». Ответ обычно лежит там.
Нормальные сроки
Новая страница на живом сайте с трафиком: от часов до нескольких дней в Google, до двух недель в Яндексе. Новый домен без истории: 1-2 недели в Google до первых страниц, 2-4 недели в Яндексе, полная индексация каталога 1-3 месяца. Отчёт «Страницы в поиске» обновляется не в реальном времени, поэтому расхождение с выдачей нормально.
Когда пора разбираться
Сайту больше 3-4 недель и в индексе ноль страниц. Или сайт был в индексе и за неделю потерял заметную долю страниц. Или конкретная коммерческая страница старше месяца не индексируется при наличии внутренних ссылок. Паника на третий день и срочные правки создают настоящую проблему из несуществующей.
Шаг 1. Что говорят панели вебмастера
Панели сразу называют причину исключения, и дальше работа идёт по статусу, а не по догадкам. В GSC откройте разбивку «Не проиндексированы» по причинам и отсортируйте по числу URL: вверху почти всегда одна системная проблема.
Два статуса, которые путают
«Обнаружена, не проиндексирована»: Google знает URL, но не приходил. Это бюджет, приоритет или сервер, вам нужны шаги 3, 4 и 7. «Просканирована, но не проиндексирована»: пришёл, скачал и решил не включать. Это качество, дубли или рендер, вам нужны шаги 5 и 6. В первом случае бессмысленно переписывать текст, во втором бессмысленно отправлять на переобход.
Остальные частые статусы читаются так же буквально: «Страница с переадресацией», «Вариант страницы с тегом canonical», «Страница является копией. Канонические версии страницы, выбранные Google и пользователем, не совпадают», «Доступ к URL заблокирован в файле robots.txt», «Обнаружен тег noindex», «Ошибка сервера (5xx)».
Яндекс.Вебмастер
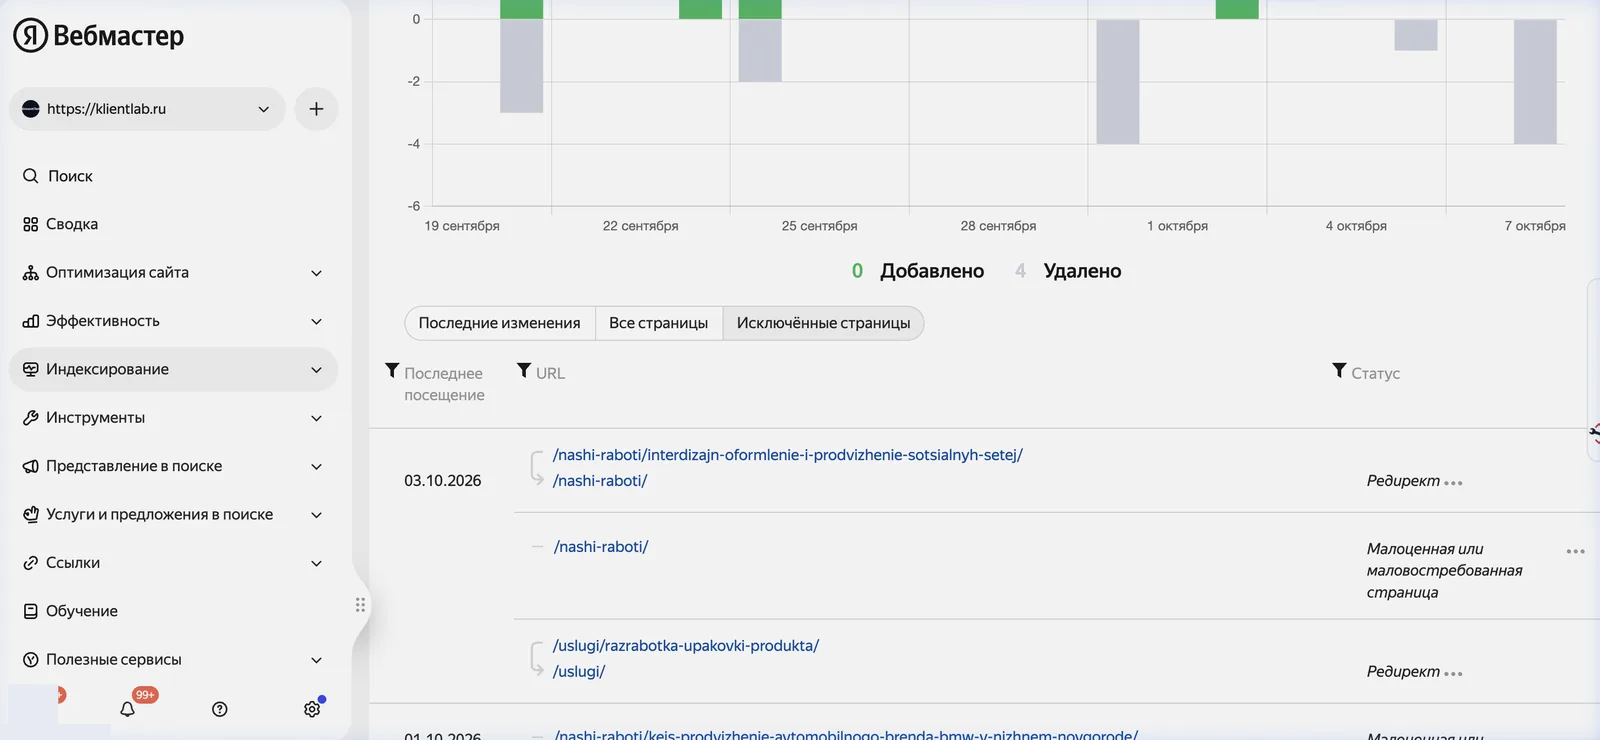
«Страницы в поиске», «Исключённые страницы»: статусы «Малоценная или маловостребованная страница», «Дубль», «Неканоническая», «Запрещено в robots.txt или метатегом noindex», «Ошибка HTTP». Недооценённый отчёт, «Статистика обхода»: сколько страниц робот скачал за день и с какими кодами. Обход упал в ноль, значит проблема на шаге 3, а не в контенте. Критичные аварии (недоступность, ошибка robots.txt, SSL) приходят в «Диагностику» раньше, чем падает трафик. Нет доступа к панелям, подключите права первым действием: без них вся диагностика гадательная.
Шаг 2. Запреты на стороне сайта
Запреты ищутся в четырёх местах: robots.txt, метатег, HTTP-заголовок и canonical. Проверять надо не главную страницу, а краулером по всему сайту: единичная проверка ничего не доказывает.
robots.txt
Откройте адрес руками и прочитайте глазами: Disallow: /, забытый запрет каталога, правило в секции для другого User-agent. Классика, разные секции для Yandex и для *: закрыли для всех, а для Яндекса правило не применилось. Проверяйте конкретные URL через «Анализ robots.txt» в Вебмастере.
Важный нюанс: robots.txt запрещает сканирование, а не индексирование. Google может держать URL в индексе по внешним ссылкам, без сниппета. Для удаления нужен noindex или 410, а чтобы робот увидел noindex, страницу надо открыть в robots.txt. Срочно скрыть: «Удаления» в GSC. В Вебмастере «Удаление страниц из поиска» сработает только после запрета (Disallow, noindex или код 404, 403, 410) и лишь ускоряет исключение.
Метатег, заголовок, canonical
Ищите в исходном коде (Ctrl+U), а не в визуальном редакторе: <meta name="robots" content="noindex"> и <meta name="yandex" content="none">. X-Robots-Tag в заголовках невидим в HTML, поэтому его пропускают: curl -I https://site.ru/page/ и читать заголовки целиком. Источники: конфиг nginx или Apache, CDN, плагин, настройки стейджинга, уехавшие в прод.
Canonical: страница указывает на другую (главную, старый домен, версию без языка) и корректно исключается как альтернативная. Проверяйте попарно, взаимная канонизация встречается. В CMS смотрите SEO-модули и свойства: в Битриксе настройки инфоблока и шаблона, в WordPress «Видимость для поисковых систем» и настройки SEO-плагина. Типовой случай: после редизайна остался глобальный noindex.
Шаг 3. Доступность для робота: коды ответа, защита, хостинг
Проверять надо так, как видит робот: curl -I с User-Agent Googlebot и YandexBot, а не браузером. Браузер часто получает 200 там, где робот получает 403.
Коды и редиректы
Рабочая страница 200, удалённая 404 или 410, переехавшая один 301 без цепочек. Цепочка из трёх и более редиректов, редирект на редирект и редирект на главную вместо 404 убивают индексацию разделов. Soft 404: страница отдаёт 200 с текстом «ничего не найдено» или пустым каталогом, Google исключает её как ложную ошибку.
Когда сайт сам отбивает робота
403 от модулей «защиты от парсинга» и shared-хостинга, 429 из-за лимитов на запросы (робот идёт быстрее человека), 503 как временная мера допустим на часы, но не на недели. Cloudflare: режим Under Attack, Bot Fight Mode, JS Challenge, правила по странам, всё это умеет отдавать роботу капчу. Смотрите Security Events с фильтром по User-Agent. Нюанс: верифицированные списки Googlebot есть почти везде, YandexBot в «известные боты» попадает не всегда, поэтому именно Яндекс чаще страдает от антибота.
Подлинность робота подтверждается обратным DNS: PTR должна разрешаться в yandex.ru, yandex.net или yandex.com для Яндекса и в googlebot.com, google.com или googleusercontent.com для Google, и обратно в тот же IP. Так вы не заблокируете нужного и не поверите подделке. Гео-ограничения хостинга дают классический кейс «в Яндексе есть, в Google нет»: Googlebot ходит в основном с американских IP, YandexBot с российских. И следите за скоростью: при ответе в 2-3 секунды и таймаутах Google сам снижает частоту обхода, это видно в «Статистике сканирования». Просроченный или неполный SSL-сертификат для робота равен недоступности.
Шаг 4. Знает ли поисковик о странице
Поисковик узнаёт о странице двумя путями: карта сайта и внутренние ссылки. Если ни там, ни там её нет, индексации не будет независимо от качества.
sitemap.xml
Карта доступна по 200, указана в robots.txt, добавлена в обе панели, содержит только канонические URL с кодом 200, абсолютные адреса на нужном домене и протоколе, не больше 50 000 URL на файл. Частые ошибки: в карте редиректы, закрытые в robots.txt адреса и страницы с другим canonical; карта сгенерировалась при установке CMS и больше не обновлялась. lastmod должен отражать реальное изменение: сегодняшняя дата во всех строках обесценивает сигнал, это не ускорение, а потеря. И помните: «есть в карте» не равно «будет в индексе».
Ссылки и ускорение
Перелинковка остаётся главным сигналом важности: страница в пяти кликах от главной и без входящих ссылок обходится последней. Сироты находятся сопоставлением списка URL из базы или sitemap с результатами краулера; типично для карточек, доступных только через фильтр или поиск. Переобход в Вебмастере лимитирован (обычно десятки URL в сутки), тратьте его на коммерчески важные страницы. «Запросить индексирование» в GSC работает, но квота небольшая и это не массовый инструмент. IndexNow поддерживают Яндекс и Bing, он реально сокращает время до обхода, но отправлять нужно только изменившиеся URL. Честный итог: переобход и IndexNow лечат задержку обнаружения, а не отказ по качеству.
Шаг 5. Отрендерился ли контент
Если текста, цен и ссылок нет в исходном HTML, для робота их может не быть вовсе. Базовая проверка: отключить JavaScript в браузере или посмотреть исходный код.
Google рендерит JS с задержкой и не всегда полностью, Яндекс хуже и позже. Для коммерческих страниц вывод один: ключевой контент и навигация должны быть в HTML. Типовые поломки: контент появляется после клика или скролла, навигация на onclick вместо <a href>, маршрутизация без реальных URL, данные с API, закрытого в robots.txt. Табы и аккордеоны допустимы, если содержимое есть в DOM; подгрузка по AJAX при клике для робота не существует. Lazy-load текста и важных блоков требует серверного рендера или загрузки по умолчанию.
Как посмотреть глазами робота
GSC, «Проверка URL», «Проверенная страница»: HTML, скриншот, заблокированные ресурсы и ошибки консоли. В Яндекс.Вебмастере есть проверка ответа сервера и отображения страницы. Отдельно убедитесь, что в robots.txt не закрыты /js/, /css/, /api/: без них робот рендерит пустую страницу. В Битриксе это частый остаток шаблонного robots.txt, проверяйте /bitrix/js/ и /bitrix/templates/. Приоритет решений: SSR или пререндер для важных шаблонов, затем контент в HTML, и только потом тонкая настройка гидратации.
Шаг 6. Робот был, но страницу отверг
Если в панели видно сканирование, а индекса нет, причина почти всегда в дублях или тонком контенте. Переобход здесь не помогает: нужно менять саму страницу.
Технические дубли: со слешем и без, /index.php, www и без www, http и https, параметры и UTM, пагинация с тем же заголовком и текстом. Контентные дубли: карточки с описанием производителя, региональные страницы, отличающиеся только названием города, услуги из одного шаблона. При дублях поисковик сам выбирает каноническую и часто не ту, которую вы продвигаете («Дубликат: Google выбрал другую страницу»).
«Мало полезный контент, коммерческая информация»
Это не статус отдельной страницы, а нарушение уровня сайта: «Малополезный контент» показывается в Вебмастере в разделе «Безопасность и нарушения». На уровне страниц похожая причина исключения называется «Малоценная или маловостребованная страница». Типичные носители: тонкие страницы услуг и городов, пустые категории, карточки без описаний и цен. Выйти можно только содержательной переработкой (уникальные данные, цены, условия, фото, ответы на вопросы) и последующим переобходом; сроки от недель до нескольких месяцев. Не работает: две тысячи знаков воды, синонимайзер, один текст с заменой города, сотни автогенерированных страниц «услуга плюс город».
Фильтр или обычный отказ
Фильтр обычно выглядит как резкое падение по всему сайту при сохранении индексации, и о нём приходит уведомление в «Диагностике», раздел нарушений. Уведомления нет, значит это почти наверняка техника или качество. Посмотрите «Качество сайта» и раздел безопасности прежде, чем строить теории.
Шаг 7. Краулинговый бюджет на больших сайтах
Бюджет становится реальной проблемой от десятков тысяч URL. На сайте в 300 страниц «не хватает краулингового бюджета» почти всегда неверный диагноз.
Посчитать просто: в GSC «Статистика сканирования» даёт запросы в сутки, в Вебмастере «Статистика обхода» загруженные страницы в день. Делите число нужных URL на суточный обход и получаете срок полной индексации. Главный пожиратель бюджета, комбинации фасетных фильтров: пять фильтров по десять значений дают десятки тысяч почти одинаковых страниц.
Что открывать, что закрывать
Ни «закрыть всё», ни «открыть всё». Открывайте комбинации, под которые есть спрос и из которых получается осмысленная посадочная (бренд, тип, размер). Закрывайте комбинаторику из трёх и более параметров, сортировки, отображение по N штук, служебные параметры. Пагинацию держите доступной для обхода, через неё робот доходит до товаров, но не делайте целевой: свои title и никакого дублирующего текста категории. UTM канонизируйте на чистый URL, а не прячьте в robots.txt то, что уже в индексе.
Самый недооценённый рычаг для крупного каталога: корректный Last-Modified и честный 304 на If-Modified-Since. Робот не перекачивает неизменившееся и тратит обход на новое. Порядок работ в типовом кейсе «200 000 страниц, робот доходит до 10 000»: сократить мусорные URL, ускорить ответ, выстроить плоскую структуру с хабами, разбить sitemap по разделам с реальным lastmod, настроить 304. И честно решить, нужны ли в индексе все 200 000: сокращение сайта часто повышает индексируемость остального.
Анализ логов сервера: за 20 минут понять, приходил ли робот
Логи это единственный способ окончательно отличить «робот не приходил» от «приходил и получил не то». Панели показывают агрегаты с задержкой, лог показывает факт: кто, когда, на какой URL и с каким кодом ответа.
Запросите у хостинга или разработчика access.log за 7-30 дней в комбинированном формате; обычно лежит в /var/log/nginx/ или доступен в панели хостинга. Дальше четыре действия: grep по YandexBot и Googlebot (визиты есть вообще?), распределение кодов ответа для робота, топ обходимых URL, список приоритетных URL, которых в логе нет ни разу.
Читается это так. Массовые 403, 429 или 5xx для робота при 200 для людей, диагноз готов, идите на шаг 3. Робот чаще всего ходит по сортировкам, фильтрам и UTM, бюджет уходит в мусор, это шаг 7. Нужных URL в логе нет, работайте с обнаружением и перелинковкой, шаг 4. Перед выводами проверьте подлинность визитов по обратному DNS: часть «посещений Googlebot» это парсеры с подменённым User-Agent. До примерно миллиона строк хватает grep и awk, дальше нужна выгрузка в таблицу или лог-анализатор.
Таблица: симптом, вероятная причина, чем проверить, что сделать
| Симптом | Вероятная причина | Чем проверить | Что сделать |
|---|---|---|---|
| В индексе 0 страниц, сайту до 3 недель | Нормальный срок | URL Inspection, «Статус URL» | Ждать, добавить sitemap и ссылки (шаг 0) |
| В индексе 0, сайту 2+ месяца | Disallow: / или глобальный noindex | robots.txt, Ctrl+U, curl -I | Снять запрет, переобход (шаг 2) |
| Есть в Яндексе, нет в Google | Гео-блокировка IP, X-Robots-Tag, canonical, JS | curl с UA Googlebot, GSC | Шаги 2, 3, 5 |
| Есть в Google, нет в Яндексе | Антибот режет YandexBot, долгий ответ, малополезный контент | «Статистика обхода», Security Events | Шаги 3, 6 |
| «Обнаружена, не проиндексирована», тысячи URL | Бюджет и приоритеты обхода | «Статистика сканирования», логи | Шаги 4, 7 |
| «Просканирована, но не проиндексирована» | Качество, дубли, рендер | Проверка рендера, сравнение с выдачей | Шаги 5, 6 |
| «Заблокировано в robots.txt», но URL в выдаче | Сканирование не равно индексирование | «Анализ robots.txt» | Открыть, поставить noindex, удалить через панель |
| Страницы пропали после редизайна | noindex со стейджинга, смена URL, пустые шаблоны | Сверка старого и нового списка URL | Шаг 2, карта 301 |
| Пропали после переезда домена | Незавершённые 301, canonical на старый домен | Проверка цепочек редиректов | Раздел про переезд |
| Карточки не индексируются, категории да | Сироты, доступ только через фильтр, тонкий контент | Краулер против списка из базы | Шаги 4, 6 |
| Индексация резко упала за неделю | 5xx, SSL, падение хостинга, выкатка с noindex | «Статистика обхода», логи | Шаг 3 |
| В индексе дубли с UTM и сортировками | Нет canonical на чистый URL | Краулер по параметрам | Шаг 7 |
| Живые страницы исключены как ложная 404 | Soft 404: пустой каталог с кодом 200 | curl, отчёт GSC | Наполнить или отдавать 404/410 |
| Проиндексировано 80%, заявок нет | Это не задача индексации | GSC «Эффективность», аналитика | Раздел про трафик |
Особые случаи: Битрикс, мультиязычность, YMYL, переезды
В этих четырёх ситуациях причины повторяются из проекта в проект, поэтому их стоит проверять адресно.
1С-Битрикс
Шаблонный robots.txt закрывает /bitrix/, /upload/ и часто /*?*, последнее правило рубит нужные фильтры и ресурсы. Проверяйте доступность /bitrix/js/ и /bitrix/templates/. В модуле «Поисковая оптимизация» и SEO-свойствах инфоблоков живут шаблоны title, description и canonical: незаполненные шаблоны дают сотни одинаковых заголовков. ЧПУ и доступность детальной страницы по нескольким путям (/catalog/ID/ и /catalog/section/ID/) требуют одного канонического варианта, как и дубли по /index.php. Композитный кеш иногда отдаёт роботу урезанную версию, сверяйте рендер через панели. Для «Умного фильтра» отдельно настраиваются индексируемые комбинации и их SEO-данные, см. шаг 7.
Мультиязычность и YMYL
hreflang должен быть взаимным и с самоссылкой, x-default желателен: односторонние указания Google не учитывает. Типовые поломки: canonical всех языковых версий указывает на английскую, и в индексе остаётся одна; языковой редирект по IP, из-за которого робот всегда видит одну версию. В YMYL-тематиках (медицина, финансы, право) техника та же, но порог качества выше: страницы без авторства, лицензий, указания специалистов и источников чаще получают «малополезный контент». Для медицины в Яндексе отдельно важны корректная информация о лицензиях и предупреждения о противопоказаниях, это требование и к размещению, и к рекламе.
Переезд и редизайн
Нужны постраничные 301 (не всё на главную), оба домена в панелях, «Переезд сайта» в Вебмастере и Change of Address в GSC, обновлённые canonical и sitemap, старый sitemap оставить доступным, 301 не снимать минимум год. Нормальная просадка 2-8 недель, восстановление до 3-6 месяцев. Перед редизайном снимите полный список URL и сверьте с новым: самая частая авария это noindex со стейджинга в проде, вторая это смена структуры URL без редиректов.
Проиндексировано, но трафика нет: почему это другая задача
Индексация даёт право участвовать в выдаче, а не позицию в ней. Страница может быть в индексе и не показываться ни по одному запросу, и это не лечится техническими правками.
Отличить просто: в GSC «Эффективность» и в Вебмастере «Запросы». Показы есть, кликов нет, значит дело в позициях и сниппетах. Показов нет вовсе, значит страница не отвечает ни одному спросу: нет собранной семантики, нет соответствия интенту, или запрос занят другим типом страниц. Отдельный случай, когда страницу вытесняет собственный дубль или более релевантная страница сайта, это каннибализация.
Дальше работают семантика, соответствие типа страницы интенту, коммерческие факторы, скорость и поведенческие. Практический смысл разделения один: не переделывать техничку, когда проблема в контенте и спросе, и наоборот.
Индексация как бизнес-метрика: что чинить первым
Цифра «в индексе 64%» не значит ничего, пока неизвестно, какие именно 36% выпали. Десять тысяч выпавших страниц пагинации не проблема, сорок выпавших страниц услуг это вопрос выручки.
Процедура рабочая и короткая: выгрузить список непроиндексированных URL, разметить по типам (услуги, категории, карточки, фильтры, блог, служебные), наложить показы, клики и заявки из аналитики за период, когда страницы были в индексе. Для страниц без истории оцените потенциал по спросу: частотность запросов, умноженная на конверсию похожих страниц. Грубо, но для приоритизации достаточно.
Приоритет работ: сначала страницы, которые приносили или могут принести обращения, затем хабы, через которые робот до них доходит, потом всё остальное. Вывод, который не любят отчёты: часть выпавших страниц возвращать не надо. Если страница не отвечает на спрос, не приносит обращений и тратит обход, её место не в индексе. Поэтому наша диагностика заканчивается не списком из 200 задач, а 5-10 пунктами с оценкой в потенциальных заявках и отдельным обоснованным списком «ничего не делать». Метрика, которую стоит вести: доля коммерчески значимых страниц в индексе и заявки с органики по этим типам страниц.
Чего делать не надо
- Прогоны по каталогам и «сервисы быстрой индексации»: в лучшем случае ноль эффекта, в худшем мусорный ссылочный профиль.
- Накрутка поведенческих ради ускорения индексации: механика вообще про другое, а риск фильтра реальный.
- Отправлять одну страницу на переобход каждый день: приоритет не растёт, квота расходуется зря.
- Закрывать «на всякий случай» в robots.txt то, что уже в индексе: страницы останутся, а влиять на них вы перестанете.
- Ставить lastmod сегодняшней датой по всему sitemap: сигнал обесценивается.
- Генерировать тысячи страниц «услуга плюс город» в надежде, что хоть часть пройдёт.
- Переписывать тексты при статусе «Обнаружена, не проиндексирована»: робот их не видел.
- Срочно менять техничку на сайте возрастом пять дней.
- Удалять и пересоздавать страницы ради «обновления URL»: теряются накопленные сигналы.
Проверка индексируемости для AI-ответов и нейропоиска
Нейро в Яндексе, AI-ответы Google и чат-сервисы с веб-доступом опираются на индекс, но добавляют свои краулеры. Проверьте, не заблокированы ли в robots.txt и на уровне WAF GPTBot, OAI-SearchBot, PerplexityBot, ClaudeBot, и отдельно посмотрите в robots.txt правила для токенов Google-Extended и YandexAdditional (это не отдельные роботы, в логах и на WAF их нет): решение открывать или закрывать должно быть осознанным, а не случайным.
Такие системы охотнее цитируют страницы с подзаголовками, которые прямо отвечают на вопрос, короткими формулировками, таблицами, явными цифрами и датами. Контент, доступный только после JS, для большинства AI-краулеров не существует, поэтому требование «ключевое в HTML» здесь жёстче, чем для Google. Разметка Schema.org (Article, FAQPage, Organization, LocalBusiness, Service) цитирование не гарантирует, но помогает машинно считать факты.
Практическая проверка: задайте 5-10 реальных вопросов по своей теме в нейропоиске и посмотрите, попадает ли сайт в источники, плюс проверьте логи на визиты AI-краулеров. Оговорка честная: трафик из AI-ответов пока измеряется плохо, и для большинства коммерческих тематик в России его доля невелика. Это задел, а не замена поисковой индексации.
Что можно сделать самому за час, а где нужен разработчик
Час своими руками
Проверить статус 3-5 важных URL в обеих панелях, прочитать robots.txt, посмотреть исходный код на noindex и canonical, сверить sitemap (доступность, свежесть, выборочно 10 URL), открыть «Диагностику» в Вебмастере и топ причин в GSC, посмотреть сайт с отключённым JS. Если умеете curl, добавьте проверку кодов и заголовков под UA робота для десяти типовых страниц.
Нужен доступ к серверу
Access-логи и их разбор, настройка Last-Modified и 304, правила WAF и Cloudflare, SSR или пререндер, массовые 301 при переезде, правила canonical в шаблонах CMS, индексируемые комбинации умного фильтра. Отдельно нужен краулер (Screaming Frog, свой скрипт или наш site-audit): полная карта URL, цепочки редиректов, дубли title, поиск сирот, проверка X-Robots-Tag по всему сайту.
Ориентир по времени: до диагноза 1-3 часа для сайта до 1000 страниц и 1-2 дня с логами для крупного каталога. Внедрение считается отдельно.
Частые вопросы
Сколько реально ждать индексацию нового сайта?
Новая страница на живом сайте: от часов до нескольких дней в Google, до двух недель в Яндексе. Новый домен: 1-2 недели до первых страниц в Google, 2-4 недели в Яндексе, каталог целиком 1-3 месяца. Разбираться стоит, если сайту больше 3-4 недель и в индексе ничего нет.
Чем «Обнаружена, не проиндексирована» отличается от «Просканирована, но не проиндексирована»?
В первом случае Google знает URL, но не приходил: это бюджет, приоритет или сервер, нужны перелинковка, ускорение ответа и чистка мусорных URL. Во втором пришёл и решил не включать: это качество, дубли или рендер, и переобход тут бесполезен.
Что значит «Мало полезный контент, коммерческая информация»?
Яндекс счёл страницу не добавляющей ценности к выдаче. Типично для тонких страниц услуг и городов, пустых категорий, карточек без описаний и цен. Выход только через содержательную переработку и переобход, сроки от недель до месяцев. Вода не помогает.
Сайт индексируется в Яндексе, но не в Google?
Ищите то, что различается для двух роботов: гео-ограничения хостинга, правила WAF и Cloudflare, разные секции robots.txt, уровень JS-рендеринга, canonical и hreflang. Проверяйте curl под каждым User-Agent и сравнивайте «Статистику обхода» со «Статистикой сканирования».
Как отличить «робот не приходил» от «приходил и отверг»?
Быстро: поле «Последнее сканирование» в URL Inspection и статус в Вебмастере. Окончательно: логи сервера, где видно и визит, и полученный код ответа. Визитов нет, работаем с обнаружением и бюджетом. Визиты есть, работаем с контентом и дублями.
Почему страница в индексе, хотя закрыта в robots.txt?
robots.txt запрещает сканирование, а не индексирование. Google может держать URL в индексе по внешним ссылкам, без сниппета. Для удаления нужен noindex или 410, причём страницу надо открыть для робота. Срочно: инструменты удаления URL в GSC и Вебмастере.
Может ли причина быть в хостинге или Cloudflare?
Да, это одна из частых причин: 403 и 429 от антипарсинга, JS Challenge и Bot Fight Mode, блокировка по странам, 5xx под нагрузкой, медленный ответ. Проверяйте curl под UA робота, Security Events и логи, а робота подтверждайте обратным DNS.
Ускоряют ли переобход и IndexNow индексацию?
Они сокращают время обнаружения и обхода, но не влияют на решение включить страницу. Лимит переобхода в Вебмастере обычно десятки URL в сутки, тратьте на коммерческие страницы. IndexNow отправляйте только по реально изменившимся адресам.
Как проиндексировать 200 000 страниц, если робот доходит до 10 000?
Не просить больше бюджета, а сокращать расход: убрать комбинаторику фасетов, сортировки и параметры, ускорить ответ, настроить Last-Modified и 304, сделать плоскую структуру с хабами, разбить sitemap по разделам. Параллельно решить, нужны ли в индексе все 200 000.
Нужно ли закрывать фильтры, пагинацию и сортировки?
Не всё и не целиком. Открывайте комбинации со спросом, из которых получается посадочная. Закрывайте комбинации из трёх и более параметров, сортировки и служебные параметры. Пагинацию держите доступной для обхода, но не целевой. Метки канонизируйте, а не прячьте.
Проиндексировано 80%, но заявок нет. Это проблема индексации?
Почти наверняка нет. Есть показы, значит вопрос в позициях, релевантности и сниппетах. Показов нет, значит страницы не отвечают спросу, и это задача семантики. Сначала посмотрите, какие именно 20% выпали: если пагинация и фильтры, индексация ни при чём.
Что происходит после переезда домена или редизайна?
Нужны постраничные 301, оба домена в панелях, «Переезд сайта» в Вебмастере и Change of Address в GSC, обновлённые canonical и sitemap, 301 минимум год. Просадка 2-8 недель, восстановление до 3-6 месяцев. Частая авария: noindex со стейджинга в проде.
Если разбираться самому некогда
Мы делаем технический аудит индексации с анализом логов: обе панели, краулер по всему сайту, access-логи, проверка WAF и CDN, рендер. На выходе список причин, карта приоритетов «что чинить первым» с оценкой в потенциальных обращениях и отдельный список того, что чинить не надо.
КлиентЛаб занимается SEO и контекстной рекламой с 2012 года: медицина, B2B и промышленность, e-commerce на 1С-Битрикс, экспортёры на Google Ads. Позиции не обещаем, считаем заявки и стоимость обращения.
Пришлите домен на бесплатный экспресс-аудит сайта или рекламы в КлиентЛаб, и мы за день скажем, есть ли проблема с индексацией вообще.
Материалы по теме
Специализируюсь на белом поисковом продвижении, AEO/GEO в нейросетях и сквозной аналитике для B2B и медицины.
Напишите нам: проанализируем ваш сайт и подскажем, как применить описанные решения на практике.
Заполните бриф: сайт, ниша, задача и конкуренты. Посмотрим спрос и текущие кампании заранее, чтобы прийти с цифрами.
Заполнить бриф