llms.txt: что это, нужен ли он вашему сайту и сколько стоит внедрение (октябрь 2026)
Содержание
- Что такое llms.txt и что он на самом деле делает
- llms.txt vs robots.txt vs sitemap.xml vs Schema.org: кто за что отвечает
- Поддерживает ли его кто-нибудь на октябрь 2026
- Яндекс, Нейро, Алиса и GigaChat: что происходит с ИИ-поиском в России
- Проверяем на своём сайте: заходили ли ИИ-боты за llms.txt
- Как измерить ИИ-трафик в Яндекс.Метрике и GA4
- Если решили внедрять: структура файла и рабочий пример
- Внедрение на 1С-Битрикс и других CMS: почему файл отдаёт 404
- Ошибки и риски: чем llms.txt может навредить
- Сколько это стоит в часах и что эти часы дадут иначе
- Что реально влияет на попадание в ИИ-ответы: 7 работ вместо одного файла
- Решение по типу бизнеса
- Если подрядчик продаёт llms.txt как услугу: какие вопросы задать
- Когда вернуться к этому вопросу
- Частые вопросы
- Итог: наша позиция и чеклист на 15 минут
На октябрь 2026 ни одна крупная ИИ-платформа официально не заявила, что использует llms.txt как сигнал. Файл не вредит, но и не даёт измеримого прироста визитов и заявок. Наша позиция: это строка в бэклоге ценой 1-3 часа, а не проект. Есть свободные 1-3 часа, делайте. Вытесняет работу с коммерческими страницами, не делайте.
Статья пригодится тем, кому подрядчик выставил счёт за «подготовку к ИИ-поиску», и тем, кто хочет проверить всё на своих данных: ниже команды для логов, настройка аналитики и сигналы, при которых решение меняется.
Таблица решения по типу сайта
| Тип сайта | Вердикт |
|---|---|
| Визитка, лендинг | Нет |
| Корпоративный B2B до 100 страниц | Можно, 1 час |
| E-commerce, 500+ SKU | Нет: поддержка дороже эффекта |
| Медиа, блог с документацией | Да, смысл есть |
| SaaS, техническая документация | Да, основной сценарий формата |
Что такое llms.txt и что он на самом деле делает
llms.txt это текстовый файл в формате Markdown в корне домена, предложенный Джереми Говардом (Answer.AI) в сентябре 2024 года. Внутри: H1 с названием проекта, абзац описания, списки ссылок с короткими пояснениями. Логика автора понятна: контекст модели ограничен, а HTML-страница на большую часть состоит из навигации, скриптов и баннеров, поэтому файл даёт чистую выжимку и карту смыслов.
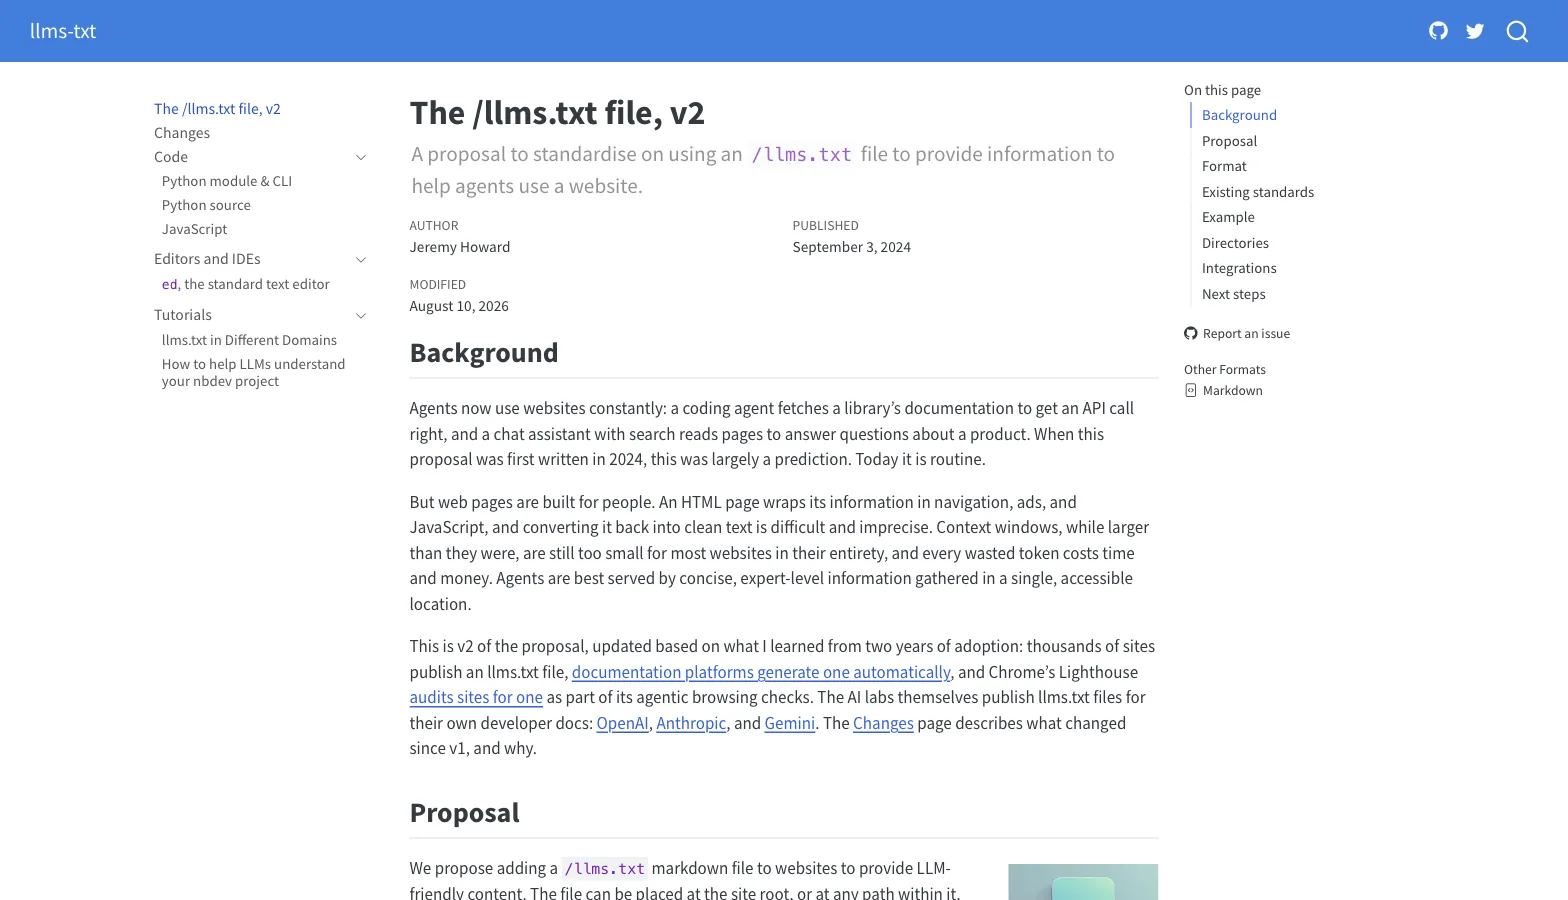
Технически файл не делает ничего сам. Это статика, которую кто-то должен сознательно запросить и прочитать. Обязательного протокола чтения нет, валидатора у поисковиков нет, отчёта в консолях нет.
Четыре частых заблуждения: файл не заставит ИИ цитировать сайт и не влияет на выбор источников в ответе; это не новый robots.txt, краулеры ходят по ссылкам и sitemap; он не запрещает обучение на контенте (запрет, это robots.txt и директивы User-agent), а наоборот приглашает читать; Google его не требует. По статусу llms.txt сегодня ближе к meta keywords в 2010-м, чем к sitemap.xml в 2006-м: идея здравая, поддержки нет.
llms.txt vs robots.txt vs sitemap.xml vs Schema.org: кто за что отвечает
| Файл | Что сообщает | Кто читает | Обязателен | Что без него |
|---|---|---|---|---|
| robots.txt | Разрешения на обход | Краулеры поисковиков и ИИ: GPTBot, ClaudeBot, PerplexityBot, YandexAdditional; Google-Extended это токен в robots.txt, а не отдельный бот; пользовательские агенты вроде Perplexity-User правила могут не соблюдать | Да, по соглашению | Нет контроля доступа |
| sitemap.xml | Список URL и даты | Google, Яндекс официально | Нет, но нужен | Медленнее индексация |
| Schema.org (JSON-LD) | Машиночитаемые факты | Google, Яндекс официально | Нет | Теряются расширенные результаты |
| llms.txt | Выжимка для LLM | Поддержка не подтверждена | Нет | Ничего |
Противоречия между llms.txt и robots.txt нет, это разные слои. Но логический конфликт возможен и опасен: если robots.txt закрывает ИИ-ботов, а llms.txt приглашает их читать разделы, вы отправляете противоположные сигналы и рисуете карту того, что сами закрыли. Правило: сначала решите, пускаете вы ИИ-ботов, и только потом думайте про llms.txt.
Поддерживает ли его кто-нибудь на октябрь 2026
Коротко: официальной поддержки нет ни у одной крупной платформы. Google: Джон Мюллер публично сравнивал llms.txt с meta keywords, документации и отчёта в Search Console нет, AI Overviews и AI Mode строятся на обычном индексе. OpenAI описывает GPTBot, OAI-SearchBot и ChatGPT-User через robots.txt, про llms.txt в документации не пишет. Anthropic документирует ClaudeBot и директивы robots.txt, при этом в экосистеме разработческой документации формат живёт широко. Perplexity документирует PerplexityBot и Perplexity-User, llms.txt как сигнал не заявляет.
Где формат реально приносит пользу: документация библиотек и SaaS, которую разработчики вручную отдают в контекст модели и агентам. Это аудитория, а не поисковая выдача.
Как перепроверить через полгода, не веря на слово: искать строку llms.txt в официальной документации краулеров платформ, а не в блогах агентств. Фраза «мы читаем llms.txt» должна быть у платформы. Данные актуальны на октябрь 2026, формат молодой, ситуация может измениться.
Яндекс, Нейро, Алиса и GigaChat: что происходит с ИИ-поиском в России
Про Яндекс в контексте llms.txt не пишут почти нигде, и это слепая зона. Нейро и ИИ-ответы Яндекса формируются поверх основного индекса и работают с теми же документами, что обычная выдача. Значит, главный путь в ИИ-ответ Яндекса идёт через обычное SEO: индексация, качество текста, ответ на вопрос в первом экране.
Показ контента сайта в быстрых ответах с YandexGPT Яндекс регулирует через robots.txt и директивы для YandexAdditional и YandexAdditionalBot, это есть в официальной документации, в отличие от llms.txt. Публичных заявлений о том, что Поиск или Алиса читают llms.txt, на октябрь 2026 нет. При этом сам Яндекс публикует llms.txt и llms-full.txt для своей Справки (например, yandex.ru/support/webmaster/ru/llms.txt): как издатель документации, а не как потребитель формата. GigaChat и другие российские сервисы это отдельные боты, свои источники данных и своя документация. Универсального файла, который «настроит» вас сразу везде, не существует.
Вывод для РФ и СНГ: если 60-90% заявок идёт из Яндекса, влияние llms.txt на вашу воронку в 2026 году равно нулю в пределах погрешности. Отдельный случай, экспортёры на Google Ads и англоязычные рынки: там долю ИИ-сервисов уже имеет смысл мерить.
Проверяем на своём сайте: заходили ли ИИ-боты за llms.txt
Это единственный способ заменить спор фактом: ответ лежит у вас на сервере. Логи nginx в /var/log/nginx/access.log*, Apache в /var/log/apache2/access.log*, на хостинге в панели (ISPmanager, cPanel, Plesk), раздел журналов. Если стоит CDN (Cloudflare, Selectel), смотрите его логи, они полнее.
# был ли запрос файла
zgrep -h 'llms' /var/log/nginx/access.log* | head -50

# какие ИИ-боты ходят и сколько
zgrep -hoE 'GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-User|Claude-SearchBot|PerplexityBot|Perplexity-User|Bytespider|CCBot|YandexAdditional' /var/log/nginx/access.log* | sort | uniq -c | sort -rn

# с каким кодом отдаётся файл
zgrep -h 'GET /llms' /var/log/nginx/access.log* | awk '{print $9}' | sort | uniq -c
Логов нет: создайте файл, подождите 2-4 недели и посмотрите лог-анализ хостинга. Интерпретация простая: ноль обращений за месяц при живом трафике ИИ-ботов по HTML-страницам означает, что файл никому не нужен. Помните, что User-Agent подделывается, поэтому смотрите на порядок величин, а не на единичные запросы.
Как измерить ИИ-трафик в Яндекс.Метрике и GA4
Прежде чем внедрять что-то «для ИИ», узнайте, сколько у вас сейчас визитов и заявок из ИИ-сервисов. Это полчаса работы, и она отвечает на вопрос приоритета.
- Домены для фильтра: chatgpt.com, chat.openai.com, perplexity.ai, claude.ai, copilot.microsoft.com, gemini.google.com, ya.ru/neuro.
- Метрика: Отчёты, Источники, Сайты. Сегмент «Домен источника содержит chatgpt.com или perplexity.ai или claude.ai», сохранить и навесить цели.
- GA4: Привлечение трафика, разбивка по Session source. Сравнение по regex chatgpt|perplexity|claude|copilot|gemini, плюс проверить канал AI Assistant в группе каналов по умолчанию (medium ai-assistant): в него попадают ChatGPT, Gemini, Deepseek, Copilot и Grok, но не Perplexity и не AI Overviews.
- На сегмент навесить конверсии: форма, звонок из коллтрекинга, заявка в CRM. Считать визиты, CR, обращения.
Нюанс: часть переходов приходит без referrer и падает в прямые заходы, поэтому цифра всегда нижняя граница. Ориентир: 40 000 визитов в месяц, из ИИ-сервисов 120 визитов (0,3%), 2 обращения. На два обращения инфраструктурные проекты не внедряют. У SaaS и B2B с англоязычной аудиторией бывает 3-8% визитов с хорошим CR, и тогда разговор становится предметным.
Если решили внедрять: структура файла и рабочий пример
Минимум спецификации: H1 с названием компании, блоквота с одним абзацем суть, пояснение, H2-разделы со списками ссылок, опциональный раздел Optional. Что задаёт спецификация: Markdown и размещение в корне (/llms.txt) либо в подкаталоге, например /docs/llms.txt. Кодировка UTF-8, Content-Type text/plain или text/markdown и абсолютные URL в спецификации не прописаны, это практические рекомендации.
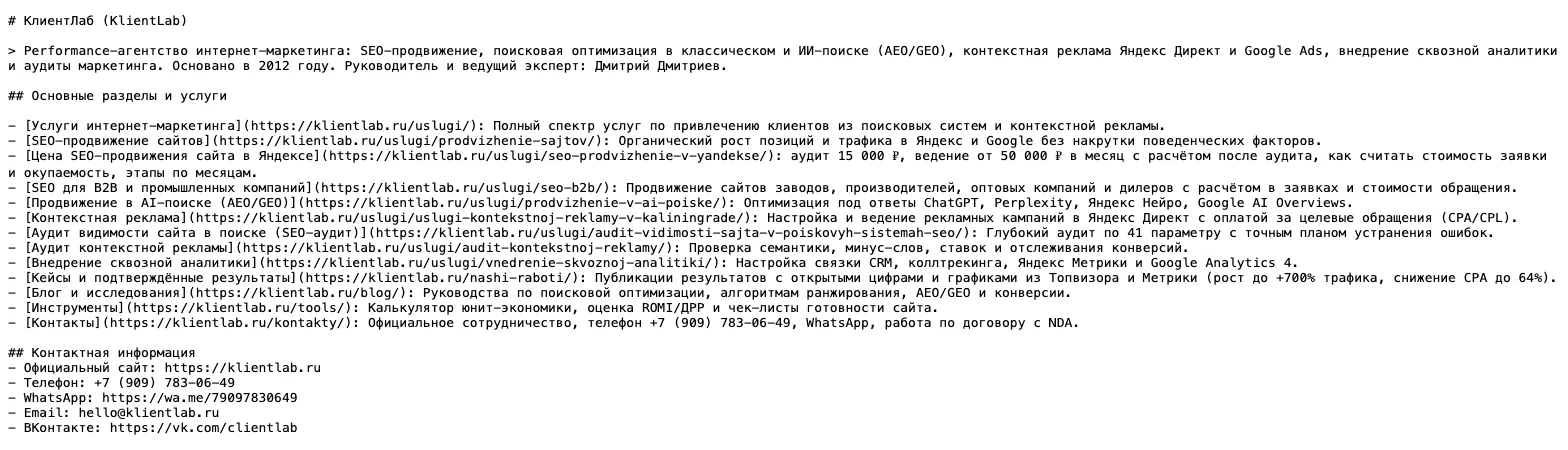
# КлиентЛаб

> Агентство SEO и контекстной рекламы для бизнеса в России и СНГ, работаем с 2012 года.

## Услуги
- [SEO-продвижение](https://klientlab.ru/uslugi/prodvizhenie-sajtov/): работы, сроки, как считаем результат
- [Яндекс Директ](https://klientlab.ru/uslugi/uslugi-kontekstnoj-reklamy-v-kaliningrade/): настройка и ведение кампаний

## Экспертиза
- [Блог](https://klientlab.ru/blog/): разборы и методики

## Optional
- [Кейсы](https://klientlab.ru/nashi-raboti/)
Описания ссылок пишутся как ответ на вопрос «что человек здесь получит», а не набором ключей. Разумный объём 30-80 ссылок: файл на 500 ссылок невозможно поддерживать. llms-full.txt это полный текст страниц одним файлом, он оправдан только для техдокументации с автогенерацией. Ручные .md-версии страниц на Битриксе почти всегда напрасная работа. В файл не кладут личные кабинеты, корзину, URL с GET-параметрами, тестовые поддомены и закрытые прайсы.
Внедрение на 1С-Битрикс и других CMS: почему файл отдаёт 404
На Битриксе запрос /llms.txt уходит в ЧПУ (urlrewrite.php) и дальше в 404.php, только если физического файла в корне нет: штатное правило .htaccess сначала проверяет существование файла (условие !-f) и отдаёт его напрямую. Варианты решения:
- Положить файл физически в корень, например /home/bitrix/www/llms.txt, права 644, владелец bitrix.
- В nginx до location / добавить: location = /llms.txt { root /home/bitrix/www; default_type text/plain; try_files $uri =404; } и перезагрузить конфиг.
- Для Apache: в штатном .htaccess Битрикса перед правилом ЧПУ уже стоит RewriteCond %{REQUEST_FILENAME} !-f, поэтому существующий файл отдаётся напрямую; проверьте, что это условие не удалено и что свои правила не перехватывают .txt.
- Без доступа к конфигам: создать файл через «Файлы и папки» в админке. Динамическая генерация через инфоблок это лишняя сущность.
Частая ошибка: файл лежит в /upload/ или /local/ и доступен по длинному URL, а не по /llms.txt. WordPress: физический файл рядом с wp-config.php, проверить плагины, перехватывающие 404. Tilda и конструкторы: доступа к корню обычно нет. Next.js и Nuxt: public/llms.txt работает без настройки. Проверка: curl -I https://site.ru/llms.txt должен вернуть 200 и текстовый Content-Type, без редиректов www и http.
Ошибки и риски: чем llms.txt может навредить
Вредит он не ранжированием, а содержимым. Пять реальных рисков:
- Публикация карты служебного. В файл по невнимательности попадают /admin, /test, /old, страницы с параметрами и закрытые разделы. Файл публичный, его читают и сканеры уязвимостей.
- Конфликт сигналов: ссылка ведёт на страницу с noindex или на неканоническую версию. В файл идут только canonical-URL с кодом 200, открытые к индексации.
- Мёртвый файл. Сделали один раз, за полгода изменились услуги и переехали страницы. Набор битых ссылок хуже отсутствия файла, потому что модель читает его как официальную выжимку.
- YMYL. Формулировка про гарантию результата, диагноз или исход дела становится готовой цитатой. Текст файла для клиники проверяет врач, а не копирайтер.
- Организационный: строка «подготовка к ИИ-поиску» в отчёте создаёт иллюзию, что направление закрыто.
Чего бояться не нужно: санкций не будет, на позиции в Яндексе и Google файл не влияет никак, индексацию не ускоряет и не замедляет.
Сколько это стоит в часах и что эти часы дадут иначе
Считать надо не «полезно ли это», а «что я не сделаю, если сделаю это». Ориентиры по трудозатратам:
- Сайт до 100 страниц: отбор страниц и описания 1-2 ч, размещение и проверка 0,5-1 ч. Итого 1,5-3 часа.
- Сайт 500+ страниц: отбор 3-5 ч, описания 3-6 ч, согласование 1-2 ч. Итого 7-13 часов.
- llms-full.txt: сборка 4-8 ч плюс скрипт автогенерации 6-12 ч, иначе поддержка нереальна.
- Поддержка, о которой не говорят: 0,5-1 ч в месяц на живом сайте, для 500+ страниц 1-2 ч. За год выходит 10-25 часов на средний корпоративный сайт.
Те же 10-25 часов в альтернативе: переписать 3-4 коммерческие страницы под реальные запросы, внедрить FAQPage на 10 страницах, закрыть технические ошибки из отчёта краулера, настроить аналитику по заявкам, сделать один материал, который приводит обращения. При доле ИИ-трафика 0,3% выбор очевиден, при 5% обсуждаем. И честная оговорка: если файл делается за час как побочный эффект, спорить не о чем.
Что реально влияет на попадание в ИИ-ответы: 7 работ вместо одного файла
- Быть в индексе. ИИ-ответы Google и Яндекса строятся на основном индексе: непроиндексированная страница не попадёт туда ни при каком llms.txt. Проверьте покрытие в Search Console и Вебмастере.
- Прямой ответ в первых 300-500 символах, без разгона «в современном мире». Модель извлекает ответ, а не читает лид.
- Извлекаемая структура: H2 формулировкой вопроса, короткие абзацы, нумерованные шаги, таблицы сравнения.
- Проверяемые факты: цифры, даты, условия, цены или хотя бы вилки. «Индивидуальный расчёт» не цитируется.
- Schema.org: Organization с адресом, годом основания и sameAs, Article с автором и датой, FAQPage, LocalBusiness или MedicalClinic. Это официально поддерживаемый способ рассказать о себе машине.
- Упоминания вне сайта: отзывы, справочники, отраслевые каталоги, публикации. Образ компании модель собирает из многих источников.
- Авторство и E-E-A-T: реальное имя, должность, опыт, для YMYL указание проверившего специалиста.
Отдельного «ИИ-SEO» как набора трюков сейчас нет: шансы в ИИ-ответах повышают те же работы, что растят органику и конверсию. Если ИИ пересказывает о вас неверно, источник ошибки почти всегда внешний, и лечится он обновлением данных в источниках, а не файлом.
Решение по типу бизнеса
| Бизнес | Вердикт и часы | Что делать вместо или вместе |
|---|---|---|
| Медицина, юристы (YMYL) | Не приоритет. Делаете, значит с вычиткой специалистом | MedicalClinic и Physician разметка, страницы специалистов с лицензиями, формулировки без обещаний результата |
| B2B и промышленность | Можно, 1-2 часа, низкий приоритет | Спецификации, расчёты, кейсы с цифрами. Побочная польза файла: заставляет сформулировать, что вы делаете, человеческим языком |
| E-commerce на 1С-Битрикс | Нет для каталога, возможно для блога | Product и Offer разметка с ценой и наличием, фиды, скорость, канонизация фильтров |
| Экспортёры, Google Ads | Да, внедрить и мерить | Делать на англоязычной версии с отслеживанием переходов в GA4 |
| SaaS, IT, документация | Да, целевой сценарий | Автогенерация llms.txt и llms-full.txt из исходников, поддержка почти бесплатна |
Если подрядчик продаёт llms.txt как услугу: какие вопросы задать
Сам факт предложения не делает подрядчика плохим. Плохо продавать это как канал привлечения и ставить выше работ, влияющих на заявки. Пять вопросов:
- Покажите официальную документацию платформы с поддержкой формата. Честно: «официальной нет, делаем на перспективу». Воздух: ссылка на блог другого агентства.
- Сколько у меня сейчас визитов и заявок из ChatGPT, Perplexity и Нейро? Честно: цифры или «не настроено, настроим за полчаса». Воздух: «ИИ-трафик не посчитать».
- Как измерим результат? Честно: обращения ботов в логах плюс динамика визитов, с оговоркой про недоказуемость причинности.
- Кто и как часто обновляет файл, входит ли это в бюджет? Молчание означает мёртвый файл через полгода.
- Что вы НЕ сделаете за эти часы?
Красные флаги в КП: «GEO-оптимизация» или «AI SEO» без привязки к конкретным страницам, контенту и замеру AI-трафика в аналитике, обещание попадания в ответы ChatGPT, llms-full.txt для интернет-магазина, отсутствие строки про поддержку. Нормальная строка выглядит так: «llms.txt: отбор страниц, описания, размещение, проверка, 2 ч, эффект не гарантирован, поддержка 0,5 ч в месяц», внизу бэклога.
Когда вернуться к этому вопросу
Решение меняют четыре сигнала:
- Формат появился в developers-документации краулеров Google, Яндекса, OpenAI или Anthropic, а не в блог-посте.
- В ваших логах появились и растут обращения ИИ-ботов к /llms.txt.
- Доля визитов из ИИ-сервисов перешла 2-3% или с них пошли заявки.
- В Search Console или Яндекс.Вебмастере появился отчёт либо валидатор по файлу.
Регламент простой: раз в квартал 15 минут. Команда по логам, сегмент в Метрике, поиск строки llms.txt в документации двух-трёх платформ. Прогноз (именно прогноз): либо формат получит поддержку и станет часовой гигиеной уровня sitemap, либо тихо умрёт, как meta keywords. Оба исхода не требуют действий сегодня, кроме дешёвой проверки.
Частые вопросы
Поддерживает ли llms.txt Яндекс, Нейро и Алиса?
Нет. Публичных заявлений на октябрь 2026 нет, ИИ-ответы строятся на основном индексе, доступ регулируется robots.txt и директивами для YandexAdditional.
Как посмотреть в логах, запрашивал ли бот файл?
Через zgrep по access-логам: поиск строки llms и подсчёт User-Agent через sort | uniq -c, код ответа через awk по 9-му полю. User-Agent подделывается.
Как отследить переходы из ChatGPT и Perplexity?
В Метрике сегментом по домену источника с целями, в GA4 сравнением по Session source с regex. Часть трафика идёт без referrer, поэтому оценка нижняя.
Почему на 1С-Битрикс файл отдаёт 404?
Запрос перехватывает ЧПУ и отправляет в 404.php. Решение: физический файл в корне, отдельный location в nginx или RewriteCond перед правилами ЧПУ.
Нужен ли файл, если robots.txt закрывает ИИ-ботов?
Нет. Формально слои разные, но закрывать ботов и публиковать для них карту бессмысленно.
Может ли файл навредить?
Да, двумя способами: утечкой служебных и закрытых URL и устареванием. На позиции он не влияет никак.
Сколько стоит поддержка на 500+ страниц?
Внедрение 7-13 часов, поддержка 1-2 часа в месяц, за первый год суммарно 19-37 часов; с llms-full.txt добавьте ещё 10-20 часов на сборку и скрипт.
Как понять, что подрядчик продаёт воздух?
Задать пять вопросов из раздела выше. Красный флаг: «GEO-оптимизация» строкой без расшифровки и обещание попадания в ответы ChatGPT.
ИИ пересказывает о компании неверно, поможет ли файл?
Обычно нет: источник ошибки внешний. Лечение это обновление справочников, Organization с sameAs и страница «О компании» с фактами.
Нужен ли клинике или юристам?
Нет, не приоритет. Решают разметка специалистов, лицензии и корректные формулировки. Делаете файл, значит с вычиткой специалистом.
Чем llms-full.txt отличается?
Это полный текст страниц одним файлом вместо карты ссылок. Оправдан для автогенерируемой документации, для магазина и сайта услуг мёртвый груз.
Какие работы реально повышают цитируемость?
Индексация, прямой ответ в первых 300-500 символах, извлекаемая структура, проверяемые цифры, Schema.org, внешние упоминания, реальное авторство.
Когда стоит вернуться к внедрению?
Зависит от четырёх сигналов: документация платформ, обращения ботов в логах, доля ИИ-визитов выше 2-3%, отчёт в консолях.
Влияет ли llms.txt на позиции?
Нет. Фактором ранжирования он не является, вес не передаёт, санкций не вызывает.
Итог: наша позиция и чеклист на 15 минут
llms.txt это не хайп и не мошенничество, а строка в бэклоге ценой 1,5-3 часа плюс поддержка. Крупные платформы поддержку не заявили, в российском ИИ-поиске файл не участвует, на позиции не влияет. Оправдан он в первую очередь для SaaS и техдокументации.
Что сделать на этой неделе
- Прогнать команду по логам: ходят ли ИИ-боты и просят ли /llms.txt.
- Создать сегмент ИИ-источников в Метрике или GA4 и посмотреть визиты и заявки за квартал.
- Проверить, что robots.txt отражает ваше решение по ИИ-ботам.
- Проверить наличие Organization и Article или FAQPage разметки.
- Если цифры нулевые, поставить напоминание на квартал и вернуться к коммерческим страницам.
Мы с 2012 года ведём SEO и Яндекс Директ и считаем результат в заявках и стоимости обращения: если нужно расставить приоритеты в бэклоге, приходите на бесплатный экспресс-аудит сайта или рекламы в КлиентЛаб.
Материалы по теме
Специализируюсь на белом поисковом продвижении, AEO/GEO в нейросетях и сквозной аналитике для B2B и медицины.
Напишите нам: проанализируем ваш сайт и подскажем, как применить описанные решения на практике.
Заполните бриф: сайт, ниша, задача и конкуренты. Посмотрим спрос и текущие кампании заранее, чтобы прийти с цифрами.
Заполнить бриф