X-Robots-Tag и noindex: как закрыть страницу от индексации в Яндексе и Google
Содержание
- Коротко: какой инструмент выбрать под вашу задачу
- Чем noindex отличается от robots.txt: обход и индексация это разные этапы
- Мета-тег robots: синтаксис, значения, где размещать
- X-Robots-Tag: когда нужен заголовок, а не мета-тег
- Готовые конфиги X-Robots-Tag: Nginx, Apache, PHP, Cloudflare
- Закрытие PDF, изображений и других файлов: единственный рабочий способ
- Как это сделать на 1С-Битрикс и других CMS без правки конфигов
- Яндекс и Google: что поддерживается и чем отличается поведение
- Главная ошибка: noindex вместе с Disallow
- Другие инструменты и когда они уместнее noindex
- Как проверить, что всё сработало
- Сроки: сколько страница выпадает из индекса
- Какие страницы закрывать, а какие ни в коем случае
- Что будет со ссылочным весом и внутренней перелинковкой
- Как открыть страницу обратно и ускорить переиндексацию
- Чек-лист: до внедрения и после
- Частые вопросы
- Если нужно закрыть страницы и не потерять заявки
Закрывают страницы от индексации обычно по трём причинам: убрать служебный мусор из индекса, скрыть дубли фильтров и пагинации, не пустить в поиск рекламный лендинг или тестовый поддомен. Многие попытки не срабатывают, потому что выбран не тот инструмент: URL закрыт в robots.txt, а в выдаче висит строка «описание недоступно».
Ниже не определение noindex, а рабочие сниппеты под Nginx, Apache, PHP и 1С-Битрикс плюс команды проверки, что робот реально получает директиву. Рамка, с которой мы в КлиентЛаб начинаем такую задачу: перед закрытием любой страницы смотрим трафик и заявки, потому что одна строка в конфиге способна вырезать источник обращений. И честное предупреждение: noindex это не приватность и не защита от посторонних.
Коротко: какой инструмент выбрать под вашу задачу
Инструмент выбирается по задаче, а не по привычке. Таблица решений:
| Задача | Что ставить | Где | Чего не делать |
|---|---|---|---|
| HTML-страница вне поиска | мета-тег robots noindex | в <head> | не добавлять Disallow |
| PDF, DOC, XLS, JPG, ZIP | X-Robots-Tag | HTTP-заголовок | искать место под мета-тег |
| Все URL с ?sort=, /filter/, /search/ | X-Robots-Tag по правилу | Nginx, Apache | закрывать фильтры со спросом |
| Дубли с одним смыслом (utm, сортировки) | canonical | в <head> | noindex |
| Страница переехала | 301 | сервер, CMS | noindex вместо редиректа |
| Товар удалён навсегда | 410 | сервер, CMS | держать 200 с noindex |
| Прайсы, договоры, личный кабинет | авторизация или доступ по IP | сервер | считать noindex защитой |
| Убрать из выдачи срочно | удаление URL в GSC и Вебмастере | панели | обходиться только панелями |
Предупреждение: noindex и Disallow на одном URL одновременно = страница останется в индексе.
Чем noindex отличается от robots.txt: обход и индексация это разные этапы
robots.txt управляет обходом: робот не заходит на URL. noindex управляет индексацией: робот заходит, читает страницу и не включает её в выдачу.
Почему Disallow не убирает страницу из выдачи
Если URL закрыт в robots.txt, но на него ведут внешние или внутренние ссылки, поисковик знает об адресе и может показать его по анкорам, без тайтла и сниппета. Логика простая: чтобы увидеть noindex, роботу нужно скачать страницу или хотя бы её заголовки. Запретив обход, вы запретили и чтение директивы.
Когда robots.txt всё-таки прав
Для экономии краулингового бюджета на крупных сайтах и для технических каталогов (/bitrix/, /local/, /cgi-bin/). Для уже проиндексированной страницы порядок такой: сначала noindex, ждём переобхода и выпадения, и только потом при необходимости добавляем Disallow.
Мета-тег robots: синтаксис, значения, где размещать
Мета-тег работает только внутри <head> и только в HTML-ответе сервера. Базовая строка:
<meta name="robots" content="noindex, follow" />Значения
noarchive: запрет сохранённой копии, работает в Яндексе, Google это правило больше не использует;nosnippetиmax-snippet: контроль сниппета, только Google (как иnoimageindexсunavailable_afterниже).noimageindex: запрет индексации изображений с этой страницы.unavailable_after: для акций с конечной датой.name="yandex"иname="googlebot": когда поведение для двух систем должно различаться.
noindex,follow или noindex,nofollow
Практический дефолт: noindex, follow, чтобы не обрывать обход внутренних ссылок, пока страница ещё обходится. Google отмечает, что после выпадения страницы из индекса ссылки с неё всё равно перестают учитываться, поэтому разница со временем стирается.
Опечатки из реальных аудитов
name="robot" вместо robots, content="no-index", тег внутри <body> из-за CMS-виджета, два конфликтующих тега на странице, тег дорисован JS и отсутствует в HTML-ответе. Для файлов мета-тег неприменим физически, об этом дальше.
X-Robots-Tag: когда нужен заголовок, а не мета-тег
X-Robots-Tag это HTTP-заголовок ответа с теми же значениями, что у мета-тега: X-Robots-Tag: noindex, follow. Можно адресовать конкретному роботу: X-Robots-Tag: googlebot: noindex, nofollow.
Четыре ситуации, где мета-тег не подходит
Нет доступа к шаблону и <head>; закрываем не-HTML файлы; нужно закрыть сотни URL одним правилом по шаблону; CMS не даёт вставить тег в конкретный тип страниц. Значения перечисляются через запятую в одной строке либо несколькими заголовками.
Приоритет при конфликте
Google при конфликте берёт более строгую директиву, Яндекс наоборот: по его справке разрешающие директивы имеют приоритет, и пара all плюс noindex будет прочитана как all. Оставляйте один источник истины, иначе отладка превращается в гадание. Заголовок не видно в «просмотре кода страницы», поэтому проверка только через curl и панели.
Готовые конфиги X-Robots-Tag: Nginx, Apache, PHP, Cloudflare
Nginx
# в блоке http
map $request_uri $robots_tag { default ""; ~^/search/ "noindex, follow"; }
map $args $robots_args { default ""; ~*(^|&)(sort|filter) "noindex, follow"; }

# в блоке server; при пустом значении заголовок не отправляется
add_header X-Robots-Tag $robots_tag always;
add_header X-Robots-Tag $robots_args always;

# файлы
location ~* \.(pdf|docx?|xlsx?|zip)$ { add_header X-Robots-Tag "noindex" always; }

# add_header из server не наследуется в location со своими add_header: там строки нужно повторить
# UTM-метки сюда не включаем: для них canonical и Clean-param
Критично: ключ always (иначе заголовок пропадёт на части кодов ответа) и понимание, что add_header в дочернем блоке стирает заголовки родительского. Это частая причина жалобы «правило написали, а заголовка нет».
Apache, .htaccess
<FilesMatch "\.(pdf|docx?|xlsx?)$">
  Header set X-Robots-Tag "noindex"
</FilesMatch>
Для query-строк: условие mod_rewrite с переменной окружения и Header set ... env=NOINDEX.
PHP
if (isset($_GET['sort'])) { header('X-Robots-Tag: noindex, follow'); }Строго до любого вывода, иначе получите headers already sent.
Cloudflare и staging
Transform Rules, Modify Response Header или воркер; после правки чистим кэш, иначе проверяете старый ответ. Тестовый поддомен закрываем заголовком на весь server-блок и всё равно ставим basic-авторизацию: noindex не мешает ни людям, ни парсерам. После каждой правки reload конфига и проверка curl, без веры на слово.
Закрытие PDF, изображений и других файлов: единственный рабочий способ
В PDF и JPG нет <head>, вставлять мета-тег некуда, остаётся только HTTP-заголовок. Один файл:
location = /upload/price-2026.pdf { add_header X-Robots-Tag "noindex" always; }Папка целиком закрывается тем же правилом на /upload/docs/.
Картинки
noimageindex в мета-теге запрещает индексировать изображения с данной страницы, а X-Robots-Tag noindex на сам файл закрывает картинку как объект. Подвох: если файл доступен по прямому URL и на него ссылаются другие сайты, одного noimageindex на своей странице мало.
Практика агентства: прайсы и коммерческие предложения в PDF регулярно выстреливают в поиске по названию компании. Закрывать нужно заголовком, а конфиденциальный документ уносить за авторизацию.
Как это сделать на 1С-Битрикс и других CMS без правки конфигов
1С-Битрикс
Точечно в шаблоне или компоненте:
$APPLICATION->SetPageProperty("robots", "noindex, follow");Массово по условию URL: обработчик в /local/php_interface/init.php на событие OnEpilog с проверкой $_SERVER['REQUEST_URI'] и вызовом header('X-Robots-Tag: ...'). Без кода в штатном Битриксе этого не сделать: во вкладке SEO инфоблока есть шаблоны title, description и заголовка, но нет поля robots. Варианты: свойство страницы robots в шаблоне компонента либо модуль из Маркетплейса. Помните про кэширование страниц: после правок чистим кэш, иначе проверяете старый ответ.
WordPress и конструкторы
В Yoast или Rank Math есть чекбокс запрета показа страницы, для массовых правил используется фильтр wp_robots. В Tilda и аналогах настройка есть на уровне страницы, а доступа к заголовкам нет, поэтому файлы там закрыть практически нечем.
Доступа к серверу нет совсем
Остаются мета-тег через шаблон, canonical и ручное удаление URL в панелях вебмастеров.
Яндекс и Google: что поддерживается и чем отличается поведение
X-Robots-Tag читают обе системы, это не гугловая фича: Яндекс описывает заголовок в своей документации для вебмастеров. Мета-тег robots с noindex понимают оба, name="yandex" нужен только для адресного обращения.
Устаревший тег вокруг текста
Парный <noindex> вокруг фрагмента был историческим решением Яндекса, Google его никогда не понимал. Надёжно закрыть «только часть текста» сегодня нельзя ни в одной системе.
Clean-param против canonical
Clean-param в robots.txt это яндексовый инструмент для параметров, которые не меняют контент (utm, sort, session_id). В Google аналога нет, там работает canonical.
Скорость реакции
По нашему опыту Google убирает страницу быстрее, Яндекс может держать её дольше и возвращаться после апдейтов. Вывод для РФ и СНГ: директивы ставим так, чтобы они работали в обеих системах, и результат проверяем в двух панелях, а не в одной.
Главная ошибка: noindex вместе с Disallow
Самая частая поломка: страницу закрыли в robots.txt и там же прописали noindex в шаблоне, а URL висит в поиске годами. Причина в том, что робот не скачивает страницу и не видит директиву, но знает об адресе по ссылкам.
Как исправить: снять Disallow, дождаться обхода, убедиться по логам или панели, что страница переобойдена, увидеть выпадение, и только потом при желании вернуть Disallow. Два родственных симптома: noindex отдаётся не на том варианте URL (робот ходит на другой слеш, www или протокол), и страница с noindex всё ещё заявлена в sitemap.xml. Sitemap в таких случаях надо чистить.
Другие инструменты и когда они уместнее noindex
noindex это запрет на показ, а не универсальный инструмент. canonical говорит, что страницы равнозначны и вес нужно склеить.
- Фильтры и пагинация. Для фильтров с реальным спросом («купить оборудование в Москве») noindex режет трафик, canonical сохраняет вес. Тотальный noindex по /page/ часто обрезает роботу путь к глубоким товарам.
- Переезды. 301 на релевантную страницу, особенно если на старый URL есть внешние ссылки.
- Удалённый товар. Есть замена: 301. URL не нужен никогда: 410. Временно нет в наличии: оставляем 200 и прячем из каталога.
- Конфиденциальное. Прайсы, договоры, личные кабинеты закрываются авторизацией, токеном или по IP. noindex не мешает открыть URL по прямой ссылке.
- Лендинги под Директ. Модерация смотрит доступность и содержание страницы, индексируемость её не касается, так что noindex сам по себе не повод для отклонения. Решение принимаем, посмотрев, есть ли у лендинга органический трафик и конверсии.
Как проверить, что всё сработало
Проверять нужно ответ сервера, а не картинку в браузере. Минимальный набор команд:
curl -I https://site.ru/page/
curl -sI -A "Mozilla/5.0 (compatible; YandexBot/3.0)" https://site.ru/page/
curl -s https://site.ru/page/ | grep -i robots
curl -I https://site.ru/upload/price.pdf
Третья команда показывает, есть ли мета-тег именно в исходном HTML, а не дорисован ли он скриптом. Вторая нужна, если на сайте разная логика по user-agent.
Панели
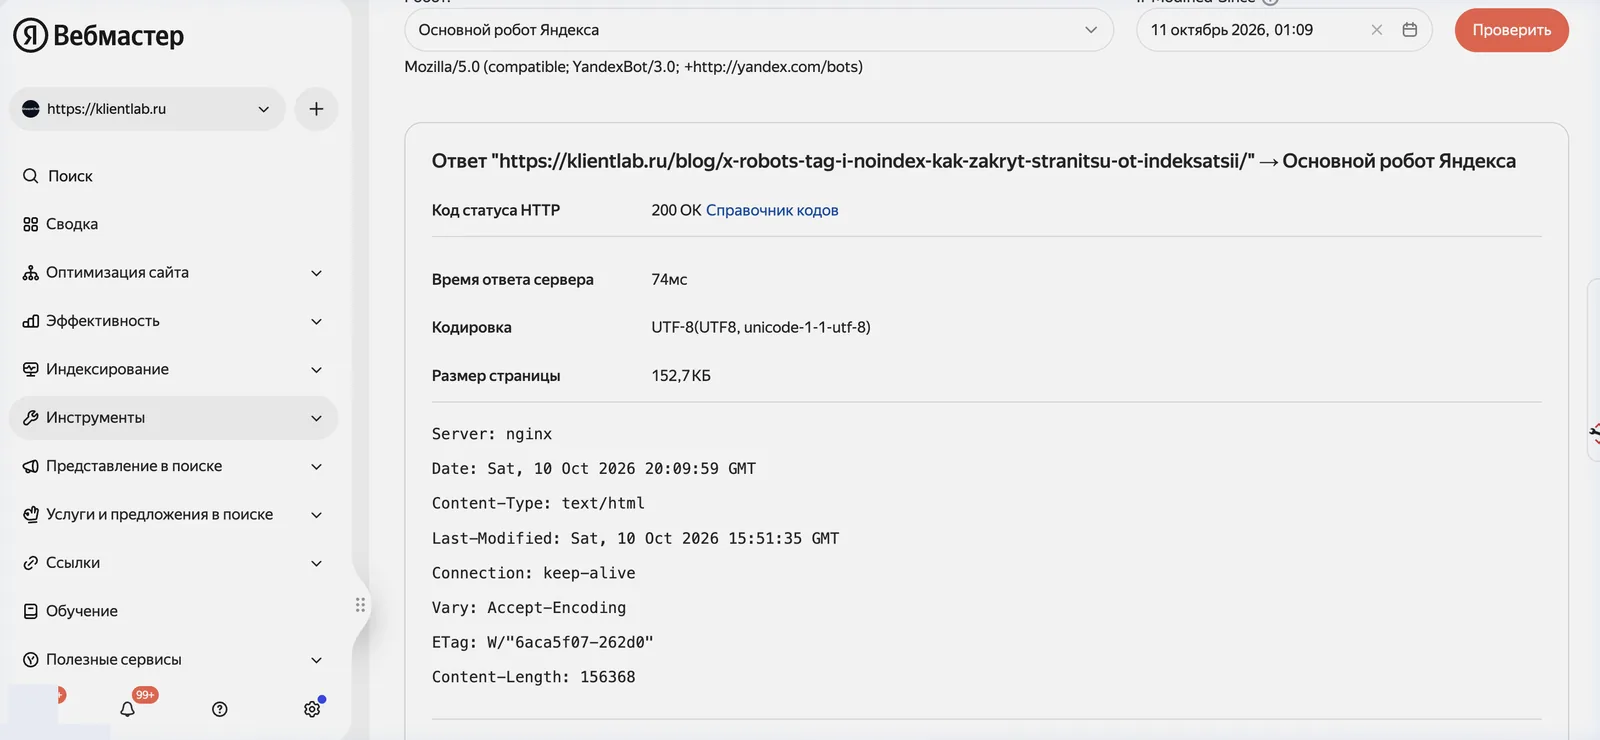
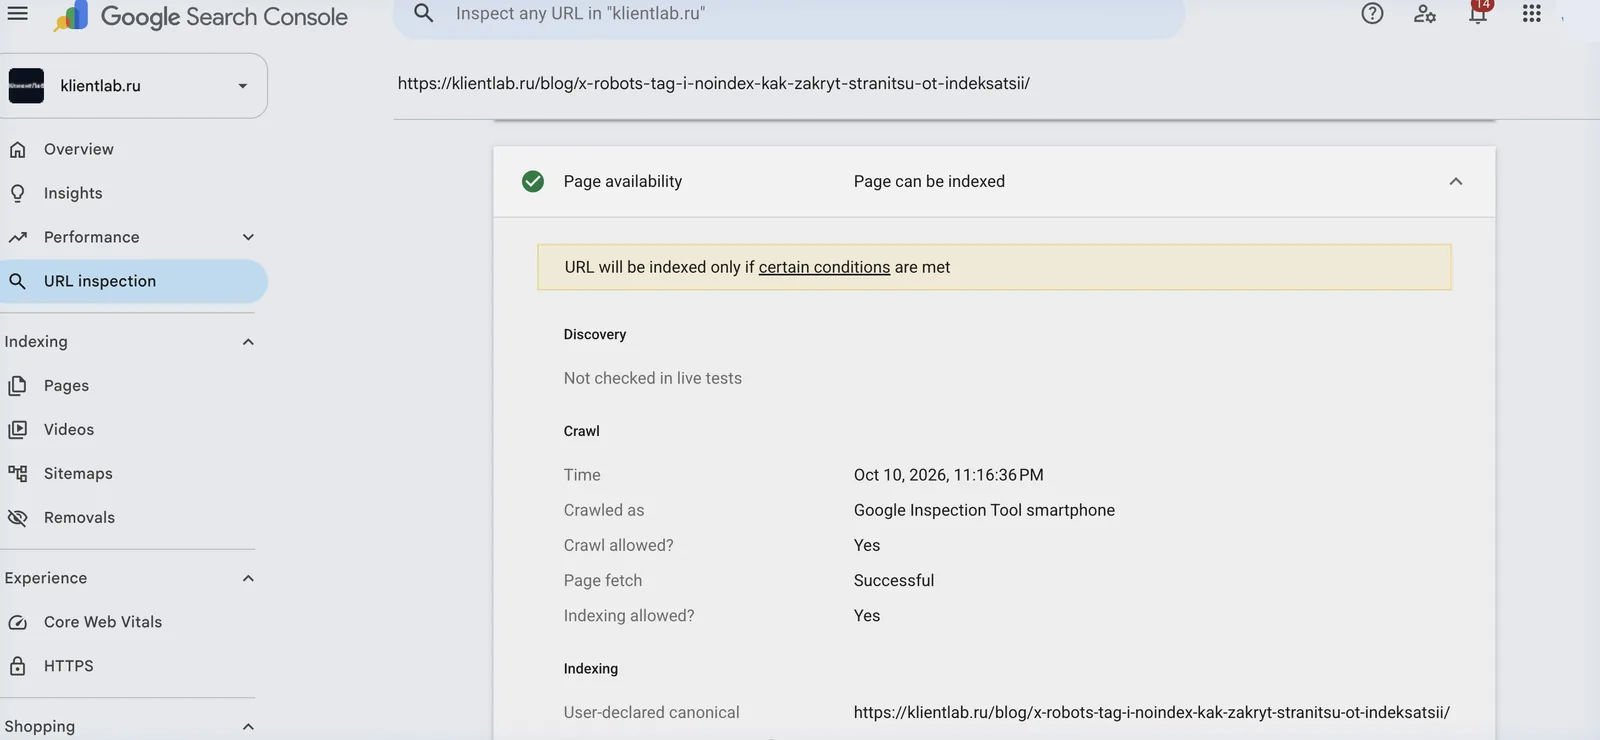
Яндекс Вебмастер, Инструменты, «Проверка ответа сервера»: показывает код, заголовки и факт запрета индексирования; факт выпадения смотрим в «Страницах в поиске». В Google Search Console это «Проверка URL» с кнопкой «Проверить страницу на сайте» и отчёт «Индексирование страниц», раздел «Исключено тегом noindex». Devtools браузера с кэшем и CDN ненадёжный источник.
Сроки: сколько страница выпадает из индекса
Срок определяет не директива, а частота обхода конкретного URL. Главная и популярные разделы переобходятся за дни, глубокая карточка за недели или месяцы.
Ориентиры из нашей практики, не гарантия поисковиков: Google от нескольких дней до 2-4 недель, Яндекс чаще 2-8 недель, иногда дольше из-за цикла апдейтов. Ускорить корректно можно переобходом в Вебмастере, Request Indexing в GSC и ссылкой на страницу из обходимого раздела. Срочное скрытие: «Удаления» в GSC (примерно на полгода), это скрытие, а не замена noindex. В Вебмастере «Удаление страниц из поиска» работает иначе: страницу сначала нужно запретить (Disallow, noindex или код 404, 403, 410), инструмент лишь ускоряет исключение, до 500 адресов в сутки.
Если noindex стоит полгода, а страница в индексе
Идём по списку: Disallow мешает увидеть директиву; директива отдаётся не на том варианте URL; CDN кэширует старый ответ; noindex добавлен через JS; URL остался в sitemap; на страницу много внешних ссылок. Если URL не нужен в принципе, меняем инструмент на 410 или 301.
Какие страницы закрывать, а какие ни в коем случае
Безопасные кандидаты: результаты внутреннего поиска, корзина и оформление заказа, личный кабинет, сравнение товаров, служебные /print/, дубли с session_id, страницы благодарности, тестовые копии.
Красный список: категории и фильтры с поисковым спросом, пагинация без альтернативного обхода, страницы услуг, блог, контакты и филиалы, страницы с отзывами.
Процедура перед массовым закрытием
Выгружаем список URL, сопоставляем с Яндекс Метрикой (визиты и достигнутые цели за 12 месяцев) и Вебмастером (показы и клики), отдельно сверяем с посадочными в Яндекс Директ и Google Ads, закрываем только то, где ноль трафика и ноль заявок. Страницы благодарности закрываем аккуратно, чтобы не сломать цель в Метрике и конверсию в Директе. Закрытие фильтров «на всякий случай» на сайте оборудования убирает длинный хвост запросов, по которому шла часть обращений. Считайте в заявках, а не в количестве вычищенных дублей.
Что будет со ссылочным весом и внутренней перелинковкой
Страница с noindex выпадает из индекса, и внешний вес, который на неё приходил, фактически перестаёт работать на сайт. Если на URL есть хорошие ссылки, правильнее не noindex, а 301 на релевантную страницу.
Внутренние ссылки учитываются, пока страница обходится; после выпадения строить на этом расчёт нельзя. Поэтому noindex, follow разумный дефолт, но не способ «перекачать вес». Массовое закрытие само по себе не роняет позиции, если закрыт мусор; проблемы начинаются, когда под нож попадают страницы со спросом или обрывается путь робота к товарам. Практический порядок: закрывать партиями, фиксировать дату, 4-6 недель следить за показами и кликами в Вебмастере и GSC и за числом заявок в Метрике.
Как открыть страницу обратно и ускорить переиндексацию
- Убрать мета-тег и правило X-Robots-Tag, перезагрузить конфиг, сбросить кэш CMS и CDN.
- Проверить
curl -Iи исходный HTML: директивы не должно быть ни в заголовке, ни в<head>. - Убедиться, что URL не закрыт в robots.txt и canonical указывает на себя.
- Вернуть URL в sitemap.xml с актуальным lastmod и поставить внутренние ссылки из индексируемых разделов.
- Отправить на переобход в Яндекс Вебмастере и на индексирование в GSC, при больших объёмах использовать IndexNow.
- Снять временное скрытие в GSC, если оно включалось: иначе страница не вернётся даже без noindex.
Ожидания честные: возврат в индекс идёт медленнее выпадения, позиции восстанавливаются не сразу и не всегда на прежнем уровне.
Чек-лист: до внедрения и после
До внедрения
- Выгружен точный список URL, проверены трафик, показы и заявки по каждому шаблону, сверены посадочные Директа и Google Ads.
- Выбран инструмент (noindex, canonical, 301, 410, авторизация), сделан бэкап конфига, решено: мета-тег или заголовок и кто вносит правку.
В момент внедрения
- Директива стоит только на целевых URL, Disallow на эти же URL снят, страницы убраны из sitemap.xml, кэш CMS и CDN сброшены.
- Пройдена проверка curl по 3-5 URL каждого шаблона, зафиксирована дата, выборочно проверено, что похожие нужные страницы под правило не попали (закрыли /search/, а /searchlight/ нет).
Через 2-6 недель
- В GSC растёт «Исключено тегом noindex», в Вебмастере страницы уходят из «Страниц в поиске».
- Показы и клики по остальным разделам без просадки, заявки в Метрике на уровне, нет роста 404 и битых внутренних ссылок. Если через 6-8 недель URL в индексе, идём по списку причин выше.
Частые вопросы
Яндекс понимает X-Robots-Tag?
Да, заголовок описан в документации Яндекса и поддерживается наравне с мета-тегом. Разница только в скорости реакции.
Как закрыть PDF или картинку?
Только заголовком: location ~* \.(pdf|docx?)$ { add_header X-Robots-Tag "noindex" always; }. В Apache это FilesMatch с Header set. Проверка: curl -I. Конфиденциальный документ уносим за авторизацию.
Почему страница закрыта в robots.txt, но в поиске?
robots.txt запрещает обход, а не индексацию. Снимите Disallow, поставьте noindex, дайте роботу скачать страницу.
Сколько ждать выпадения?
Ориентиры из нашей практики, не гарантия поисковиков: Google от нескольких дней до 2-4 недель, Яндекс чаще 2-8 недель. Ускоряется переобходом, в Google ещё и временным скрытием через «Удаления».
Как закрыть все URL с фрагментом адреса в Nginx?
По пути: location ^~ /search/. По параметру: if ($args ~* "(^|&)(sort|filter)"). Не забудьте always и помните про перекрытие add_header во вложенных блоках.
Закрывать лендинг под Директ? Не отклонит ли модерация?
Индексируемость модерацию не касается, noindex сам по себе не причина отклонения. Закрывать стоит, если лендинг дублирует сайт и не приносит органики. Сначала посмотрите визиты и заявки по URL в Метрике.
noindex или canonical для пагинации и фильтров?
canonical сохраняет вес, noindex запрещает показ. Фильтры со спросом либо оставляем в индексе, либо канонизируем. Тотальный noindex по пагинации рискует обрезать путь к товарам.
noindex,follow или noindex,nofollow?
Дефолт: noindex, follow. После выпадения страницы ссылки с неё всё равно перестают учитываться, так что разница стирается. nofollow нужен редко, например на страницах с пользовательскими ссылками.
Как убедиться, что заголовок получает робот?
curl -I, при разной логике по user-agent дополнительно curl с -A и строкой YandexBot. Плюс «Проверка ответа сервера» в Вебмастере и «Проверить страницу на сайте» в GSC.
Как убрать страницу из выдачи прямо сейчас?
Инструмент «Удаления» в GSC (скрытие примерно на 6 месяцев) и удаление URL в Вебмастере. Параллельно обязательно noindex или 410, иначе страница вернётся.
noindex стоит, а страница в индексе полгода?
Проверьте robots.txt, вариант URL (слеш, www, протокол), кэш CDN, не дорисован ли тег через JS, нет ли URL в sitemap. Если URL не нужен, ставьте 410 или 301.
Защищает ли noindex документы от посторонних?
Нет. Файл остаётся доступен по прямой ссылке любому, включая парсеры. Нужна авторизация, токен или ограничение по IP.
Теряет ли сайт позиции при массовом закрытии?
Если закрыт настоящий мусор, нет. Просадки бывают, когда под правило попадают страницы со спросом. Закрывайте партиями и следите за метриками 4-6 недель.
Как вернуть страницу в индекс?
Снять директиву, сбросить кэш CMS и CDN, проверить curl -I, снять временное скрытие в GSC, вернуть URL в sitemap с новым lastmod, добавить внутренние ссылки, отправить на переобход. Возврат медленнее выпадения.
Можно закрыть часть текста на странице?
Надёжно нет. Парный тег вокруг фрагмента был яндексовым историческим решением, Google его не поддерживал. Вынесите текст на отдельную страницу с noindex или за авторизацию.
Удалённый товар: 404, 410, 301 или noindex?
Есть аналог: 301 на него. URL чистим навсегда: 410, он выпадает быстрее 404. Временно нет в наличии: оставляем 200 и убираем из каталога. noindex здесь почти никогда не лучший вариант.
Если нужно закрыть страницы и не потерять заявки
КлиентЛаб работает с 2012 года: SEO и контекстная реклама для медицины, B2B и промышленности, e-commerce на 1С-Битрикс, экспортёров на Google Ads. По этой задаче делаем технический аудит индексации, список URL под закрытие со сверкой по трафику и заявкам, готовые правила под ваш стек и контроль выпадения в течение 4-6 недель. Результат считаем в заявках и стоимости обращения, а не в позициях, поэтому любое техническое изменение сначала сверяем с деньгами.
Что сделать на этой неделе
- Выгрузить список URL, которые планируете закрыть, и сверить их с визитами и целями в Метрике.
- Проверить, нет ли на этих URL одновременно Disallow и noindex.
- Прогнать
curl -Iпо 3-5 адресам каждого шаблона, включая PDF. - Сверить список с посадочными страницами Яндекс Директ и Google Ads.
- Внедрить правило партией и зафиксировать дату для контроля.
Пришлите домен и доступ к Вебмастеру: сделаем бесплатный экспресс-аудит сайта или рекламы и скажем, что у вас лишнего в индексе и что трогать нельзя.
Материалы по теме
Специализируюсь на белом поисковом продвижении, AEO/GEO в нейросетях и сквозной аналитике для B2B и медицины.
Напишите нам: проанализируем ваш сайт и подскажем, как применить описанные решения на практике.
Заполните бриф: сайт, ниша, задача и конкуренты. Посмотрим спрос и текущие кампании заранее, чтобы прийти с цифрами.
Заполнить бриф